In-silico構造生成(In-silico structural generation)
背景
イオン導電は「構造」に強く支配される物性です。既知構造をベースとした材料探索はすでに"red ocean"となっており、新規構造を発見すること自体に高い意義があります。新規相が見つかれば、そこから元素置換を展開することで、広い材料空間を切り拓けるためです。
実験的な新規構造の発見と構造解析の高いコスト
実験的に新規構造を発見し、その構造を解析するまでには、次のような多くのハードルがあります。
- 未知相にたどり着けるか(確率論的な要素が大きい)
- その存在に気づけるか(主観に左右される)
- 組成と温度の多次元空間の中から、未知相を単相として得られるか(試行錯誤が必要)
- 未知構造の格子サイズと空間群を決定できるか(解析的に求まるが難易度が高く、一意に決まらない対称操作もある)
- 未知構造の原子配列を決定できるか(モンテカルロ法など、確率論的な手法による)
- 回折パターンを再現する構造モデルを作製し、精密化のループ(Rietveld解析⇄モデル修正)を回せるか
考えたこと
そこで、計算から構造を探索できないかと考えました。少なくとも原子配列については、実験の構造解析(直接空間法)でもモンテカルロ的に決めているのですから、計算を起点にしても同じことができるはずです。
課題
フルスクラッチで構造を生成する場合は、格子サイズ、元素種、元素比率、原子座標(xyz)という多くの自由度を扱う必要があります。組成が既知の場合でも、原子座標の組み合わせは単位格子あたりの原子数に対して指数関数的(∝ exp(単位格子あたりの原子数))に増加します。組成が未知の場合は組成を変えながら探索することになりますが、安定構造が存在しない組成(単位格子内の元素比)で、(ほぼ)無意味な構造探索を強いられることになります。したがって、組成未知のin-silico構造生成は非現実的と言えます。
構造生成・予測の先行事例
遺伝的アルゴリズム(GA)
遺伝的アルゴリズムによる構造探索には、DFTベースのもの(非常に高コストで、現実的には収束しないはずです)と、MLPベースのもの(低〜中コスト)があります。GAのコードとしてはUSPEXやCrySPYが知られています。
深層学習
深層学習を用いた手法としては、GAN(Generative Adversarial Network)やVAE(Variational Auto Encoder)が低〜中コストで利用できますが、精度はよく分かっていません。デコード可能な畳み込みNNを用いる手法もあります。これらは数年前に流行しましたが、最近の動向ははっきりしません。
拡散モデル
拡散モデルは、似た構造を生成しやすい傾向があるかもしれません。DeepMindもこの分野に力を入れているとのことです。
XRDとのデータ同化
XRDとのデータ同化はコンセプトとして非常に優れていますが、まだ事例は少ない状況です(Prof. Tsuneyuki)。
ランダムサーチ
ランダムサーチにはPyXtal、ASE、AIRSSといったツールがあり、MLPを利用することで現実的な手法になってきました。このうちPyXtalとAIRSSは、対称性の制約の下で構造を生成します。
分子動力学計算
分子動力学計算によるアプローチは、アモルファスのMDから結晶子を成長させるというイメージです。この手法はa2c moduleとして公開されています(M. Aykol, A. Merchant, S. Batzner, J. N. Wei et al., Predicting emergence of crystals from amorphous precursors with deep learning potentials, Nature Computational Science, 2024。コード:https://github.com/jax-md/jax-md/blob/main/jax_md/a2c/crystallizer_utils.py )。
手順としては、まず100原子ほどのセルでNVT計算を行ってアモルファス構造を作り、そのアモルファスの中から結晶化しかけている部分構造(subcell)を探します。体積を固定したNVTで、やや大きめのセルを使うことが重要と考えられます。アモルファスの中に安定な配置が集まる「掃き溜め」を作るイメージです。ただし、この方法ではシンプルで格子エネルギーの高い構造ばかりが現れる可能性もあります。Li伝導体などを探したい場合は、より大きいセルでMDを行い、subcellを探索する際にはLiを除いた構造で探すのが良いかもしれません。その後、subcellと元のセルの対応を見ながら、subcell中の空隙(void)にLiを挿入します。高温での原子拡散と安定配置の形成という点で、この計算手法は実験での安定相の合成に近づいてきていると言えます。
構造テンプレート設計
構造テンプレート設計は知見ベースのアプローチで、骨格テンプレート(パッキング)を流用し、その隙間に任意の原子を挿入します。最近はこの種の報告が多く、結局のところ、知見に基づいて構造を作る方が納得感があって良いと感じます。
元素置換
元素置換のアプローチとしてはGNoMEやMatterverseが挙げられ、汎化性能の高いUniversal potentialの利用による高速化が期待されます。ただし課題として、誤った組成(実験的に決められた組成の曖昧さなどに由来)を入力して探索しても、(ほぼ)意味が無いという点があります。計算アルゴリズムとしては組成を可変にできることが望ましいのですが、安定組成へと自動で導いてくれる手法は少ないのが現状です。この観点からは、セルが十分に大きければ相分離も扱えるアモルファスMDが良いかもしれません。もしくは、GNN特有のサイトエネルギーから不安定サイトを除外するアルゴリズムを実装するのも一案です。
利用可能な汎用ポテンシャル
MatBench(Matbench Discovery)では、わずか1年でSoTA(最高性能)のモデルがMACEからeqV2(EquiformerV2)に更新されました。常にSoTAをキャッチアップし続けるのは現実的ではありませんが、OMat24データセットで学習したeqV2(eqV2-OMat)は革新的なので、使っておいた方が良さそうです。OMat24は、MDやボルツマン分布に従うように原子を変位させた非平衡状態の構造を含むデータセットで(L. Barroso-Luque et al., arXiv, 2024, https://doi.org/10.48550/arXiv.2410.12771 )、Matlantisとほぼ同じコンセプトです。依然としてMatlantisに優位性はありそうですが、訓練データが非公開のブラックボックスである点が欠点です。一方、OMat24のモデルは公開されているため使いやすく、構造生成にもいろいろと応用できそうです。詳しくはGNNのページを参照してください。
サイトエネルギーを活用した組成可変の構造探索
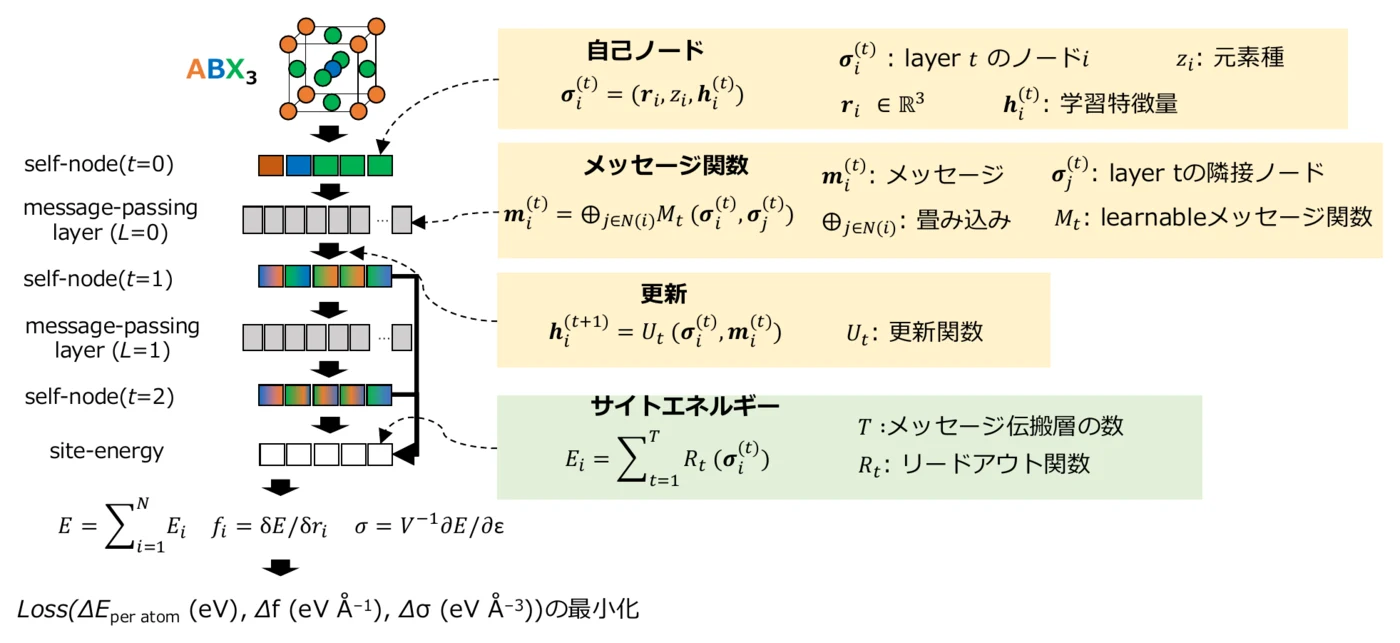
メッセージ伝搬型のGNNでは、各原子(ノード)の状態σi(t) = (ri, zi, hi(t))(位置、元素種、学習特徴量)を、隣接ノードとのメッセージmi(t)を使って層ごとに更新します。最後にリードアウト関数Rtで原子ごとのサイトエネルギーEiを出力し、その和を全エネルギーEとします。学習では、原子あたりのエネルギー、力、応力の誤差からなる損失関数を最小化します。アーキテクチャとしてはMACEなど(高精度かつ低計算コスト)を採用でき、例えばメッセージ伝搬層を64チャネル、L = 0, 1(同変性NN)とし、多体間相互作用を13体まで考慮する設定が考えられます。このときカットオフ半径rij = 6 Åでも、2層のメッセージ伝搬によって12 Å先までの情報が畳み込まれます。損失関数にはHuber loss(エネルギー、力、応力の重みを1 : 10 : 100とする)などを用います。
このサイトエネルギーを使い、サイトエネルギーの高い原子を除外していけば、自ずと安定組成へたどり着くのではないかと考えています。Preferred Networksも同様のことに言及していました。実装は簡単そうなので、この発想と遺伝的アルゴリズムを組み合わせると良さそうです。
今後の展望
今後の大きな問いは、組成・構造をフルスクラッチで探索できるのか、という点です。科学者の知見で構造を生成するアプローチ、拡散モデルによる構造生成、ランダム配置による構造生成、遺伝的アルゴリズムによる構造生成、高温MDによる結晶構造生成といった異なる構造生成アルゴリズムの間では、まだベンチマークが取られていません。単純に、LGPSのようなLiの配列が複雑な構造を予測できるかというベンチマークを取るだけでも面白いはずです。また、GNNベースのエネルギー計算ではサイトエネルギーが計算できるため、不安定サイトを特定・除去しながら組成を変化させることで、組成可変の安定構造探索もできるはずです。これは特に遺伝的アルゴリズムやランダムサーチにおいて有用と考えられます。
参考:構造生成・構造予測に関する先行研究
講義の参考スライドで紹介した先行研究の要点と、それに対する所感をまとめます。図は各論文を参照してください。
構造ラベル予測
古典的なアプローチとして、特定の定比組成を対象に、原子(またはイオン)のサイズなどをもとに構造地図を作る方法があります。D. G. Pettiforは、元素ごとに独自のパラメーターχを定め、χAとχBの二次元空間で二元系ABの構造を分類できることを示しました(D. G. Pettifor, Solid State Communications, 51, 31–34, 1984)。
機械学習による分類学習も行われていますが、予測できるのは結晶系や空間群などに限られます。例えばHafizらは、f電子系の構造データベース(約82,000構造)を作り、格子定数、体積、空間群を特徴量として、多層パーセプトロン(MLP)、ロジスティック回帰(LR)、k近傍法(KNN)で結晶系を予測し、MLPで高い精度を得ています(H. Hafiz et al., npj Computational Materials, 2018, 63)。
GANによる結晶構造予測
Kimらは、原子座標と格子定数を点とベクトルで表す「point cloud」の考え方で構造を表現し、GANで構造を生成しました(S. Kim, J. Noh, G. H. Gu, A. Aspuru-Guzik, Y. Jung, ACS Central Science, 6, 1412–1420, 2020)。入力が構造情報そのままなので構造生成が容易で、二次元データのため三次元のボクセルデータよりメモリ消費を抑えられます。読みやすい論文です。学習データには、Materials ProjectからMg–Mn–O三元系の112組成・1,240構造を取得し、回転、スーパーセル化、並進で各組成1,000構造まで増やした計112,000構造を用いています(特定の組成空間に特化したモデルを作らなければならないのか、という疑問は残ります)。生成した9,300構造をDFTで評価したところ、Ehull < 200 meV/atomの構造が多く見つかり、そのうち80 meV/atom以下の合成可能そうな構造が35個、Materials Projectに未登録でEhull < 5 meV/atomのMgMn4O8も見つかっています。ただし、結局のところ最安定構造は見つけられていません。
Longらは、生成した構造の生成エネルギーをフィードバックしながら構造生成を行うcrystal constrained DCGAN(CCDCGAN)を提案し、Bi–Se系で検証しました(T. Long et al., npj Computational Materials, 2021, 66)。DCGANの学習には103程度の入力構造が必要ですが、Bi–Se系はMaterials Projectに17構造しかないため、二元系のプロトタイプ構造から20原子以下・格子定数10 Å以下のものを選んだ9,810構造を入力データとしています。こちらも最安定構造は見つかっておらず、USPEXと同程度の精度という印象です。
VAEによる逆設計
Nohらは、格子と原子をガウス関数でぼかした3Dボクセル画像として表現し、二段階のオートエンコーダー(1段目:画像の圧縮によるフィンガープリント化、2段目:VAEによる材料空間の構築とEhullに基づく安定・不安定の二値判別)を用いた逆設計手法(iMatGen)をV–O系に適用しました(J. Noh et al., Matter, 1, 1370–1384, 2019)。潜在空間でのサンプリングは遺伝的アルゴリズムより安定材料の発見効率が高いものの、やはり最安定構造は出ておらず、それらしい構造を生成しているだけではないかとも感じます。
深層学習による結晶構造予測
Ryanらは、ICSDとCODから品質基準(R因子 < 10%、占有率 > 0.98など)で選んだ51,723構造を用い、結晶学的に非等価なサイトごとの局所構造を、動径分布関数のような原子フィンガープリントで画像として表現して深層学習しました(K. Ryan, J. Lengyel, M. Shatruk, J. Am. Chem. Soc., 140, 10158–10168, 2018)。三次元の幾何的配置を表すために、着目サイトの周りに四面体の頂点に相当する4つの観測点を置いてフィンガープリントを作っている点が特徴です。予測では、既知構造から元素情報を取り除いたサイトを構造テンプレートとして使い、あらゆる元素を当てはめて新しい化合物を作り、その尤もらしさ(likelihood)で妥当性を評価します。局所構造しか学習しないので構造テンプレートが必要で、使い勝手は良くなさそうですが、確率としてlikelihoodを予測する点は使いやすそうです。